فراداده یک روش اساسی برای امکان کشف و تأثیر منابع علمی مانند داده های (تحقیق) و اشیاء مرتبط است. باید به طرحی که به طور دقیق توصیف شده است که ویژگی های آن را توصیف می کند، پایبند باشد،[1] و چنین رکورد ابرداده متناظر جزء اجباری یک مخزن داده (تحقیق) است. دسترسی به رکورد با فعال کردن یک DOI (شناسه شی دیجیتال) برای هر آیتم در مخزن انجام می شود، مانند:
https://data.datacite.org/application/vnd.datacite.datacite+xml/10.14469/hpc/15994
https://data.datacite.org/application/vnd.datacite.datacite+xml/10.5281/zenodo.20657236
کجا 10.14469/hpc/15994 و 10.5281/zenodo.20657236 (در این مثال دو) DOI برای یک مجموعه داده مخزن خاص ثبت شده است. دو مخزن مختلف در اینجا نشان داده شده است زیرا ابرداده ها هنوز عمدتاً با استفاده از رابط کاربری مخزن مربوطه ضبط می شوند و غنا یا کامل بودن ابرداده می تواند به طور قابل توجهی بین مخازن متفاوت باشد. اگرچه یک رکورد فراداده ثبت شده دارای برخی از مؤلفه های اجباری است، بسیاری دیگر اختیاری هستند، و اغلب اتفاق می افتد که این مؤلفه های اختیاری یا پشتیبانی نمی شوند. از طریق رابط بصری از مخزن یا کاربر انتخاب می کند که آنها را نادیده بگیرد (ورودی فراداده کامل یا “غنی” می تواند برای یک انسان بسیار خسته کننده باشد). این جنبه از زمان انسان و گستره توجه آنها اغلب می تواند منجر به سوابق پراکنده ابرداده شود.
در برخی موارد، ابرداده ها با استفاده از یک گردش کار برنامه ریزی شده گرفته می شود و سپس با استفاده از معادل یک رابط خط فرمان (API) ثبت می شود که نیازی به مشارکت کاربر یا پاسخ های تعاملی کاربر ندارد.[2] و تمایل به تولید سوابق فراداده کامل تری دارد. متأسفانه، من فکر میکنم که این روش ارائه ابرداده باید نسبتاً نادر باشد – اگرچه اگر منصفانه باشیم، خود رکورد ابرداده جزئیات مکانیسمی را که به وسیله آن ابرداده جمع شده است را بیان نمیکند. دو مثال بالا دقیقاً با استفاده از API یکسان تهیه شدهاند و تا حد زیادی در این که هر یک از دو مخزن بالا واقعاً از چه عناصری از طرح ابرداده مشترک پشتیبانی میکنند، تفاوت دارند، نه در موردی که فرد حوصلهاش را داشت.
بنابراین، این یک پیشرفت خوشایند است که DataCite اخیراً داشبوردی را ارائه کرده است که اجازه می دهد تا در یک نگاه یک رکورد فوق داده خاص یا مجموعه ای از چنین رکوردهایی ایجاد شود. نقطه شروع https://metadata.datacite.org/ است و در اینجا میتوانید رکورد را بر اساس الف) مخزن، ب) سال ثبت نام و ج) نوع منبع فیلتر کنید (شکل 1). بدین ترتیب: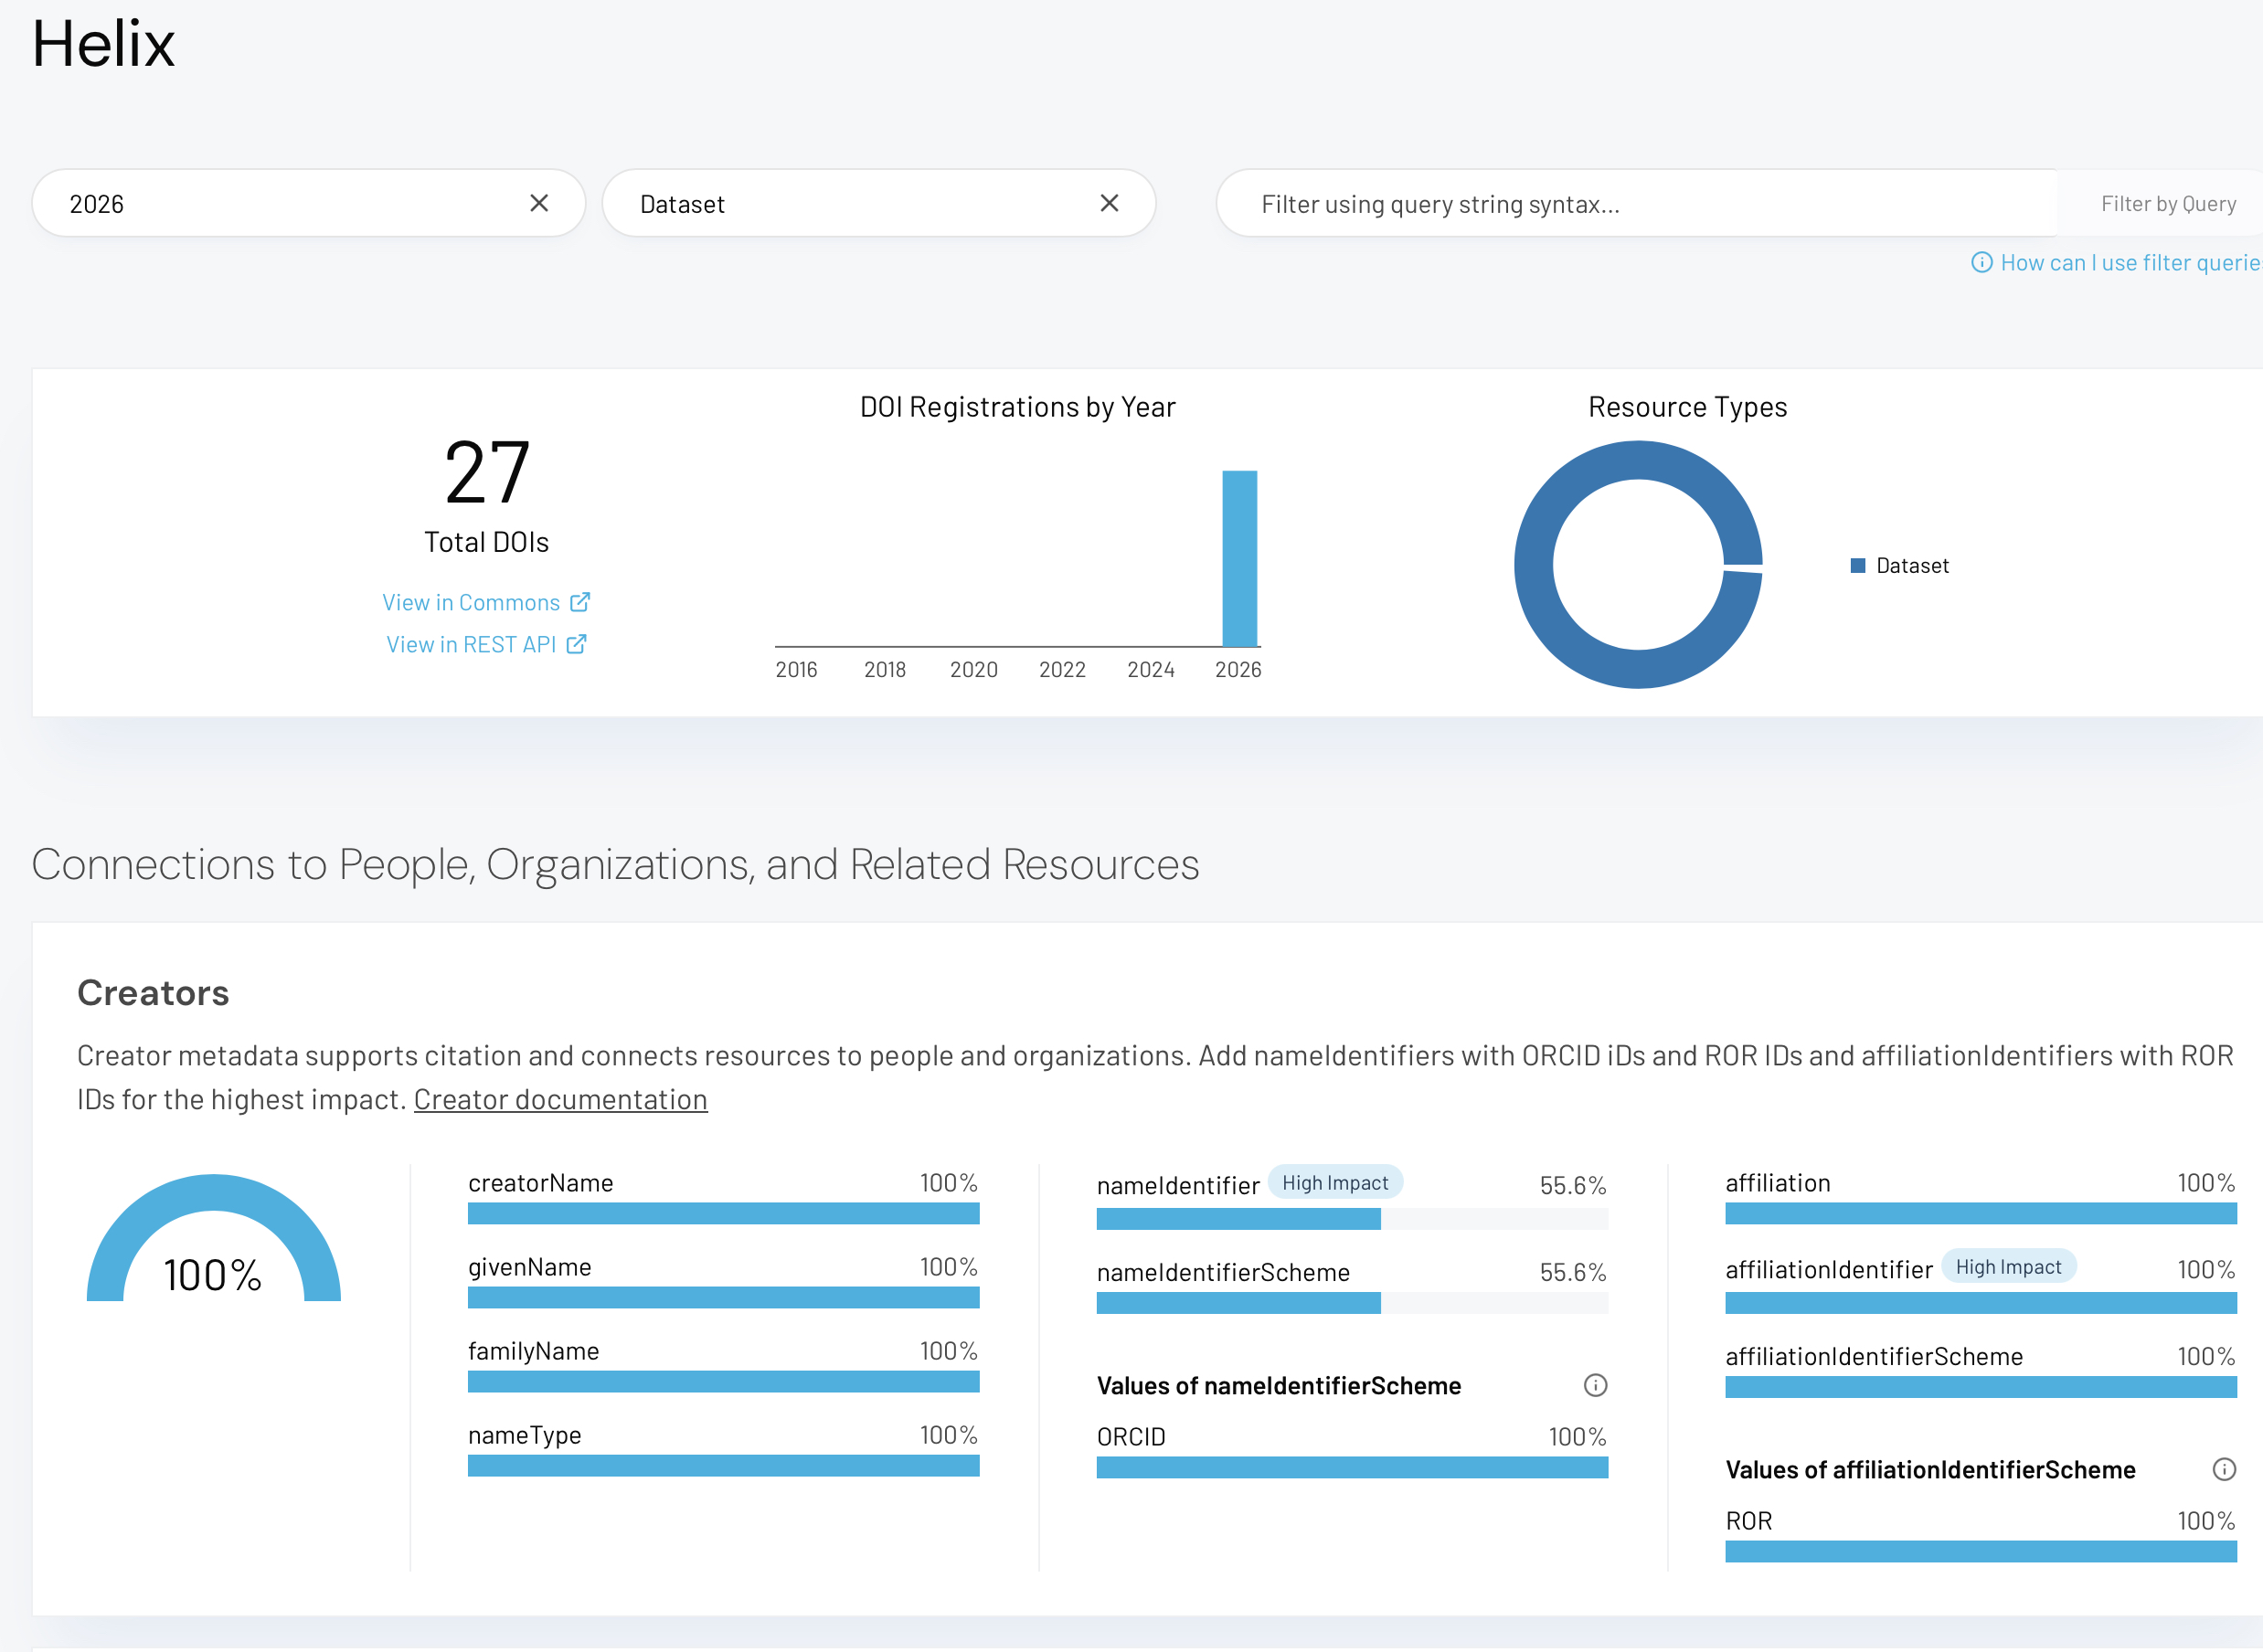
شکل 1. داشبورد ابرداده DataCite یک مخزن خاص را با پرس و جو نشان می دهد
https://metadata.datacite.org/urks.helix?registrationYear=2026&resourceType=dataset
این داشبورد اکنون به شما امکان می دهد به راحتی دو رکورد فوق داده ذکر شده در بالا را با استفاده از یک فیلتر پرس و جوی DOI اضافی که می تواند برای محدود کردن بیشتر به یک مجموعه داده واحد (پرسش های 1 و 2) استفاده شود، مقایسه کنید.
- https://metadata.datacite.org/urks?registrationYear=2026&query=id:10.14469/HPC/15994
- https://metadata.datacite.org/cern.zenodo?registrationYear=2026&query=id:10.5281/zenodo.20657236
تفاوت محسوس بین این درخواست ها است موضوعات ابرداده، به عنوان مثال با طرح موضوعی به عنوان مثال 100٪ کامل است 1 (شکل 2) و برای مثال 0% کامل است 2 (شکل 3).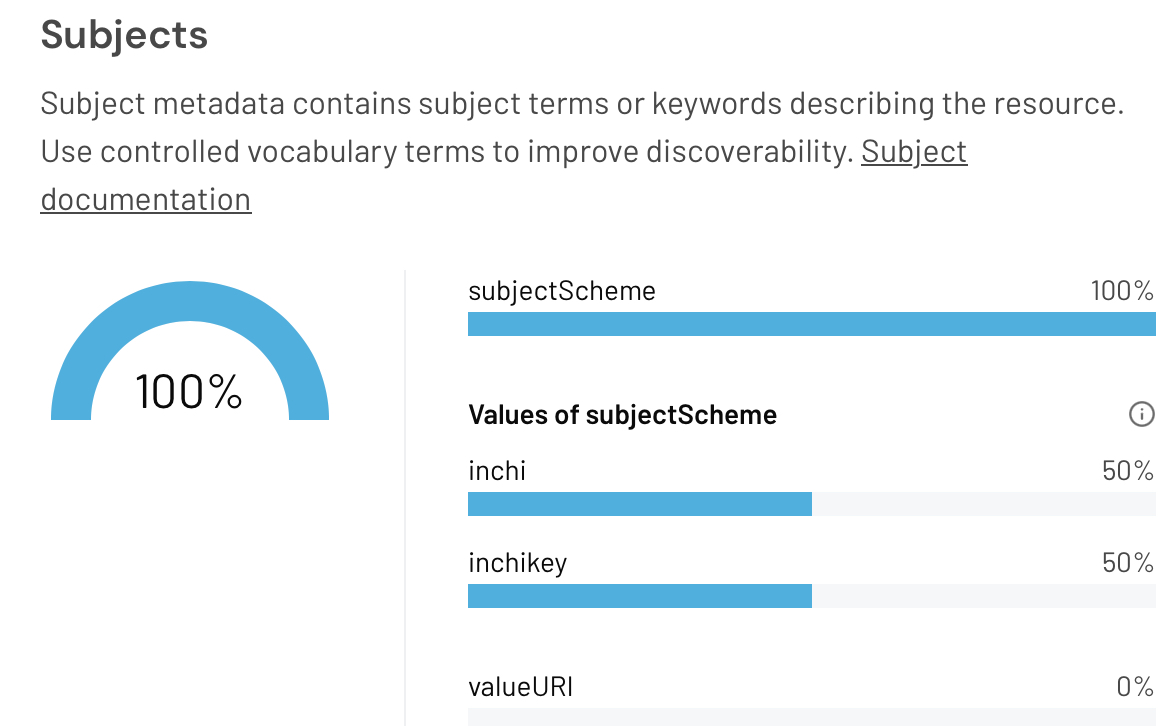
شکل 2. پانل موضوعات داشبورد ابرداده DataCite برای DOI: 10.14469/HPC/15994
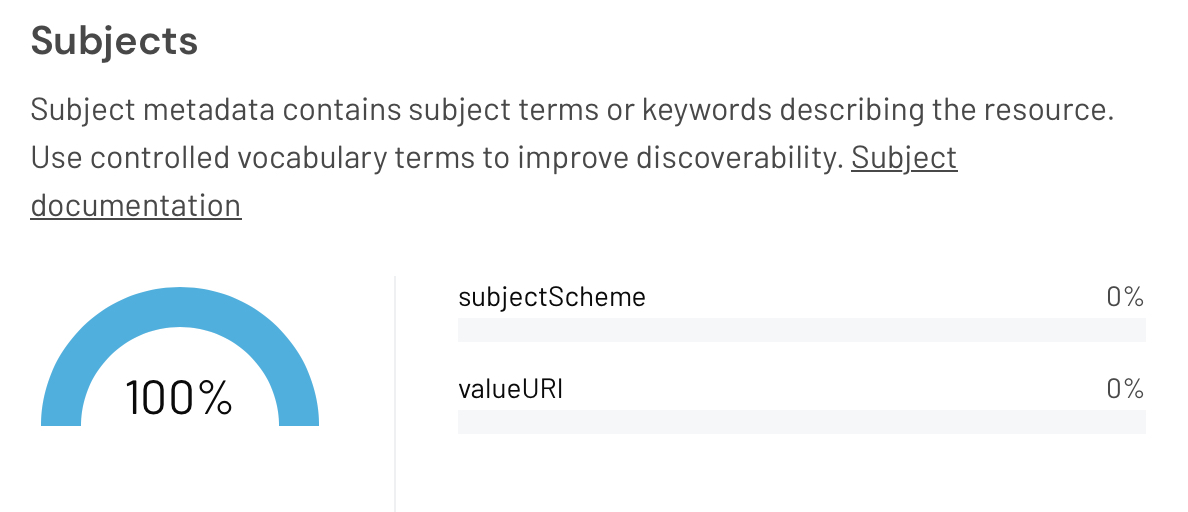
شکل 3. پانل موضوعات داشبورد ابرداده DataCite برای DOI: 10.5281/zenodo.20657236
استفاده از فیلتر پرس و جو برای کاوش در طیف وسیعی از جستجوهای دیگر.
جستجوها 3 و 4 یک سپرده گذار را با شناسه ORCID و سال 2026 را به عنوان سال انتشار برای دو مخزن مختلف مشخص کنید.
- https://metadata.datacite.org/bl.imperial?registrationYear=2026&query=contributors.nameIdentifiers.nameIdentifier:0000-0002-8635-8390+OR+creators.nameIdentifiers.nameIdentifier:*0-508-0000
- https://metadata.datacite.org/cern.zenodo?registrationYear=2026&query=contributors.nameIdentifiers.nameIdentifier:0000-0002-8635-8390+OR+creators.nameIdentifiers.nameIdentifier:*0-028-0000
این موضوعات پانلها در شکلهای 4 و 5 نشان داده شدهاند. در این مثالها، هر دو مجموعه سپردهگذاری با استفاده از یک API خط فرمان خودکار انجام میشوند.[2] بنابراین خطای انسانی یا عدم توجه دلیل تفاوت ها نیست.
شکل 4. پانل موضوعات داشبورد ابرداده DataCite برای مخزن bl.imperial برای query 3.
شکل 5. پانل موضوعات داشبورد ابرداده DataCite برای مخزن cern.zenodo برای query 4.
جستجوی 5 استفاده مستقیم تری از a را نشان می دهد موضوع فیلتر (شکل 6) و استفاده از این فیلتر تضمین می کند که دوباره پانل ابرداده موضوع به خوبی پر شده است.
- https://metadata.datacite.org/urks?query=(media.media_type:application/zip+OR+media.media_type:chemical/x-mnova)+AND+
(subjects.subjectScheme:*NMR_Nucleus)+AND+(subjects.subject:13C)+AND+
(titles.title:*pyrazole*+OR+descriptions.description:*pyrazole*)
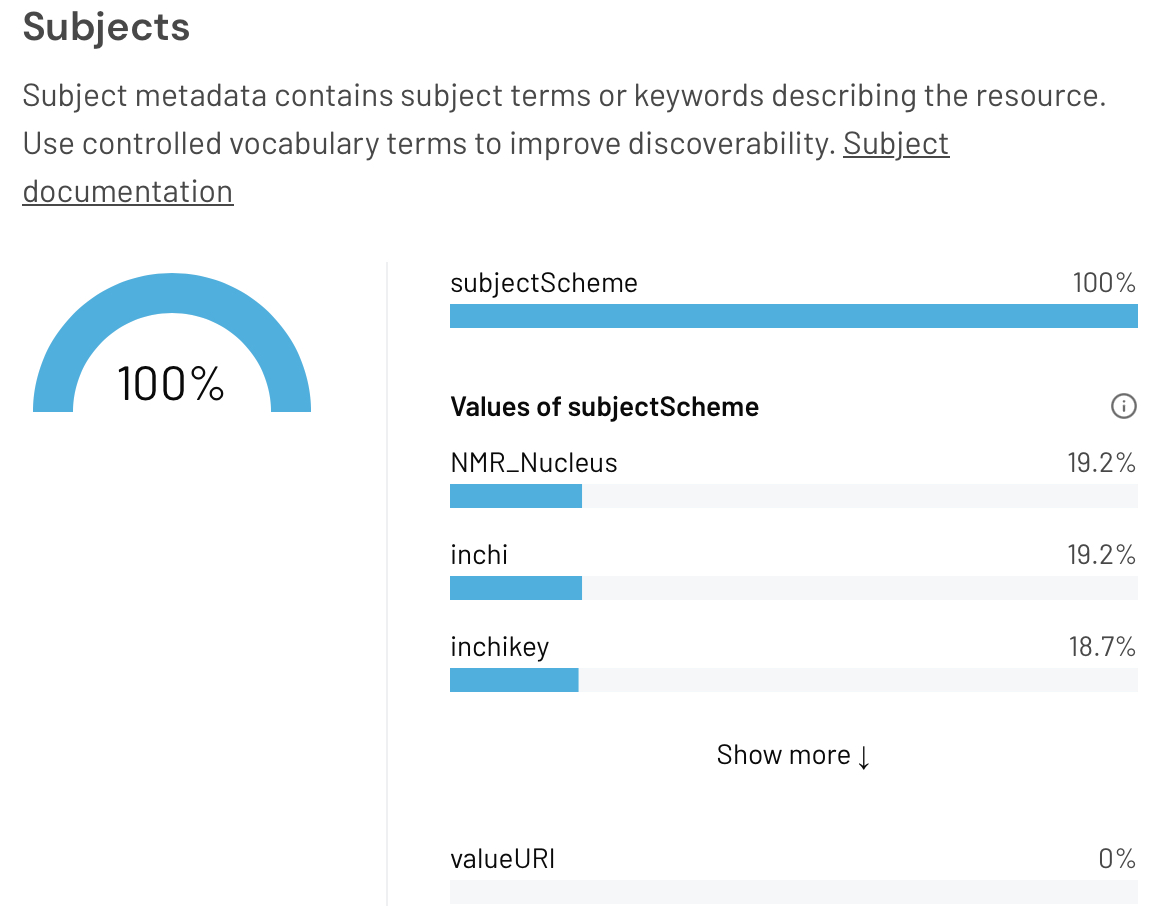
شکل 6. پانل موضوعات داشبورد ابرداده DataCite برای مخزن urks برای query 5.
پرس و جو 6 (شکل 7) مجموعه داده هایی را شناسایی می کند که دارای یک مقاله مجلات مستقیماً مرتبط هستند، که جمعیت “تأثیر بالا” را نشان می دهد. connectIdentifier دارایی
- https://metadata.datacite.org/urks?query=(types.resourceTypeGeneral:Dataset+OR+types.resourceTypeGeneral:Collection)+AND+
(contributors.nameIdentifiers.nameIdentifier:*0000-0002-8635-8390+OR+
creators.nameIdentifiers.nameIdentifier:*0000-0002-8635-8390)+AND+(relatedIdentifiers.relatedIdentifierType:DOI+AND+
relatedIdentifiers.resourceTypeGeneral:JournalArticle+AND+relatedIdentifiers.relatedIdentifier:*)
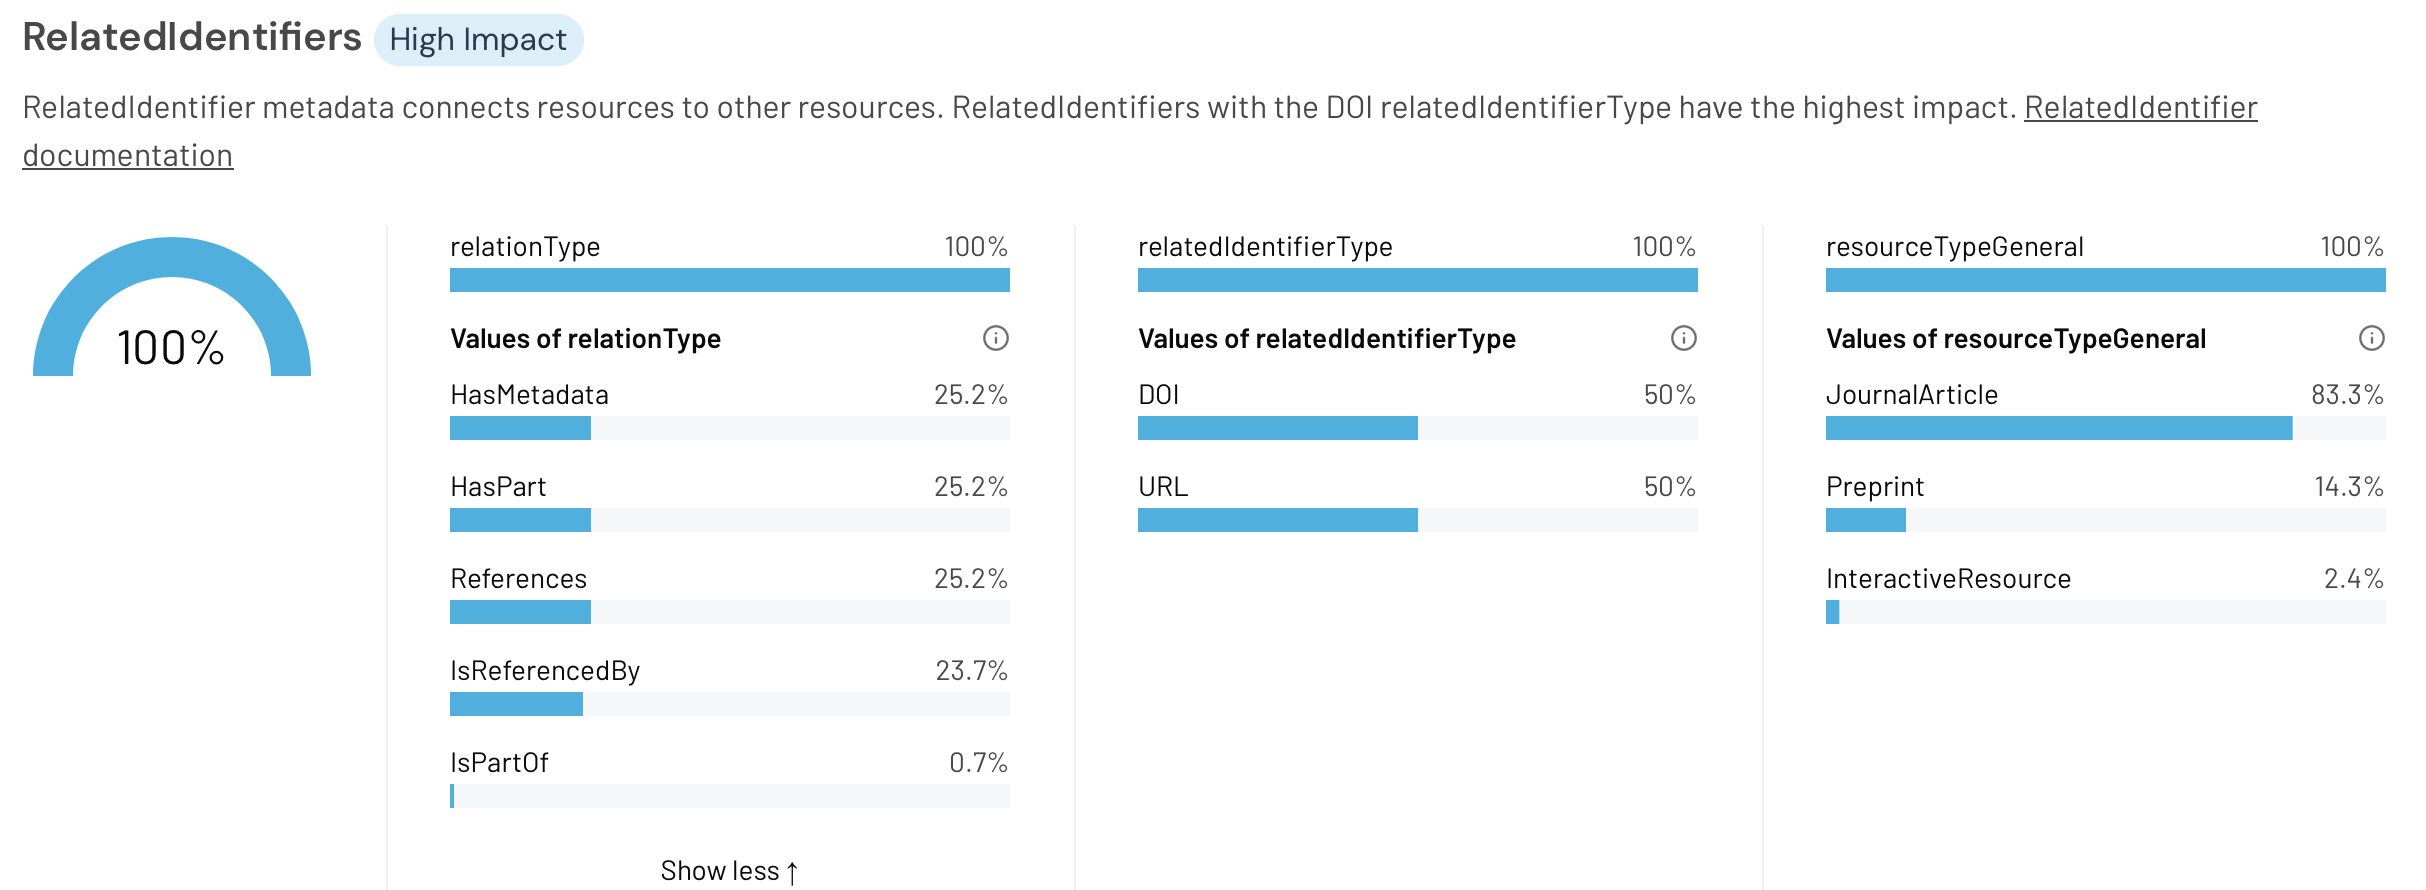
شکل 7. پانل RelatedIdentifiers داشبورد ابرداده DataCite برای مخزن urks برای query 6.
Query 7 دوباره یک پانل Subjects با جمعیت بسیار خوب (بدیهی است که به دلیل فیلتر اعمال شده در زیر است) با 100% اشغال موضوعی را نشان می دهد.
- https://metadata.datacite.org/urks?query=(media.media_type:chemical/x-gaussian-log+OR+
media.media_type:chemical/x-gaussian-checkpoint)+AND+
(titles.title:*Endo*+OR+
descriptions.description:*Endo*+OR+titles.title:*Exo*+OR+descriptions.description:*Exo*)+AND+
(subjects.subjectScheme:*KIE*)+AND+
موضوعات.موضوع:1H/2H
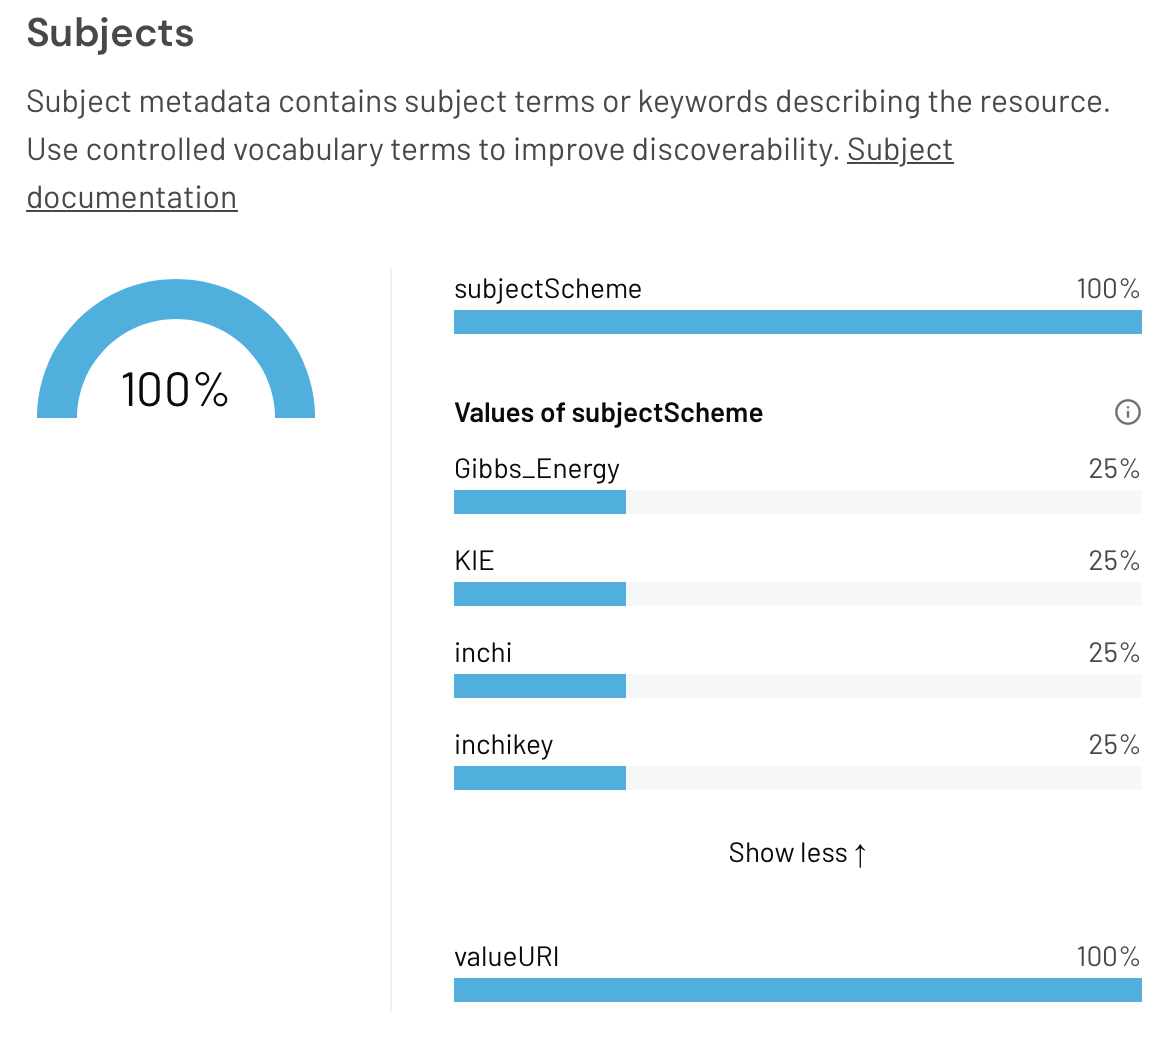
شکل 8. پانل موضوع داشبورد ابرداده DataCite برای مخزن urks برای query 7.
پرس و جو 8 نشان می دهد که چگونه پنل تم برای طیف وسیعی از کاربران پر شده است (به جز یک مظنون که به تم ها علاقه دارد!). جالب است که ببینیم آیا این جمعیت (البته فقط 4.7٪) از طریق ورودی دستی به دست آمده است یا از طریق تماس های خودکار API.
- https://metadata.datacite.org/cern.zenodo?registrationYear=2026&query=+NOT+
(contributors.nameIdentifiers.nameIdentifier:0000-0002-8635-8390+OR+
creators.nameIdentifiers.nameIdentifier:*0000-0002-8635-8390)
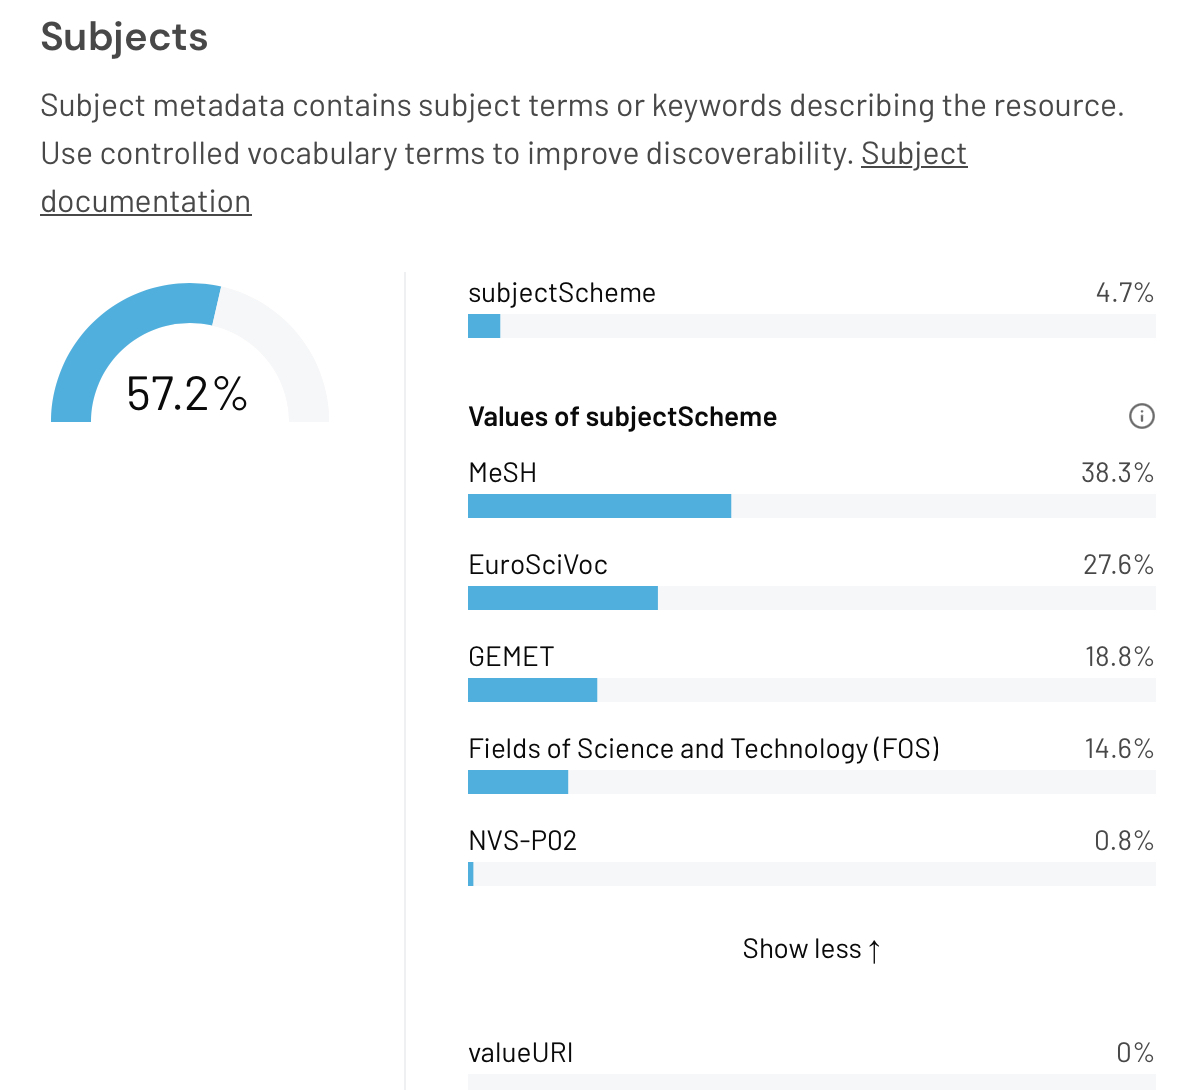
شکل 9. پانل موضوعات داشبورد ابرداده DataCite برای مخزن cern.zenodo برای query 8.
مثال 9 از سیستم مخزن InvenioRDM در حالی که استفاده می کند 10 از یک مخزن اختصاصی ایجاد شده در سال 2016 با در نظر گرفتن غنای ابرداده استفاده می کند.[2] هر دو نمونه به جای استفاده از یک ابزار API، “به صورت دستی” ساخته شده اند و فقط توسط رابط های کاربری هر مخزن محدود می شوند.
- https://metadata.datacite.org/urks.helix?registrationYear=2026&query=id:10.82186/xjxch-zzb72
- https://metadata.datacite.org/bl.imperial?registrationYear=2024&query=id:10.14469/hpc/14835
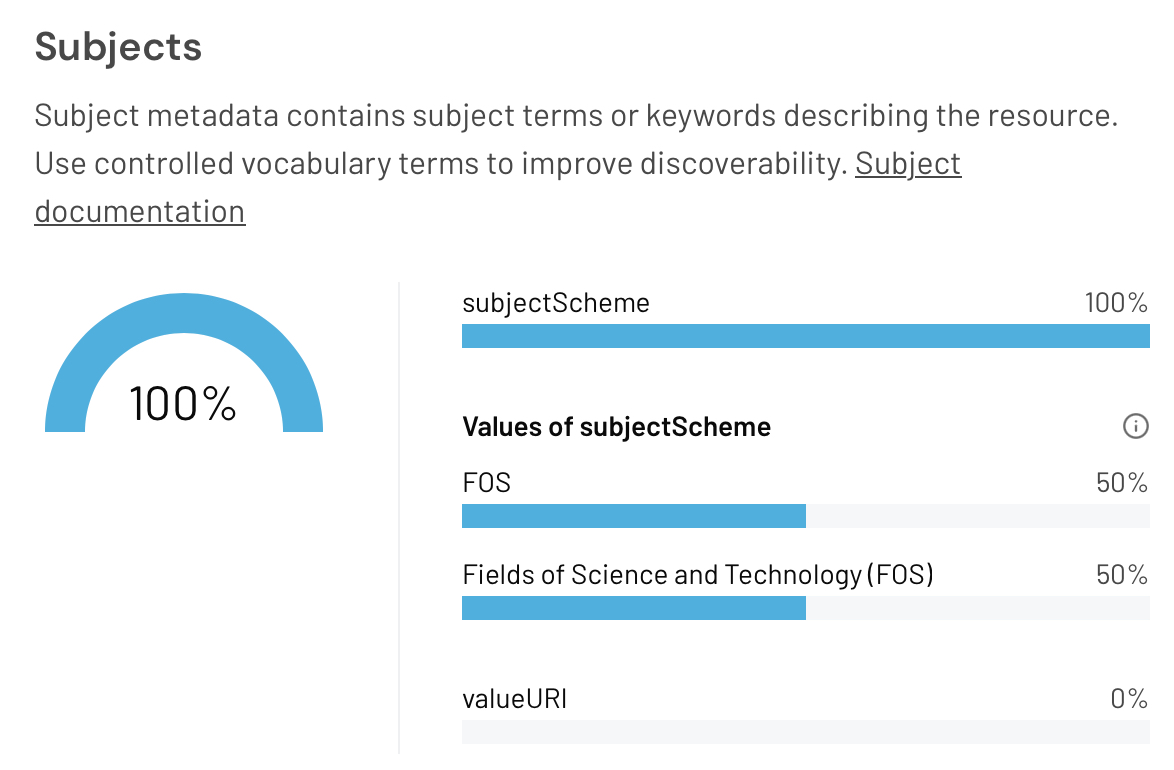
شکل 10. پنل موضوعات داشبورد ابرداده DataCite برای Query 9.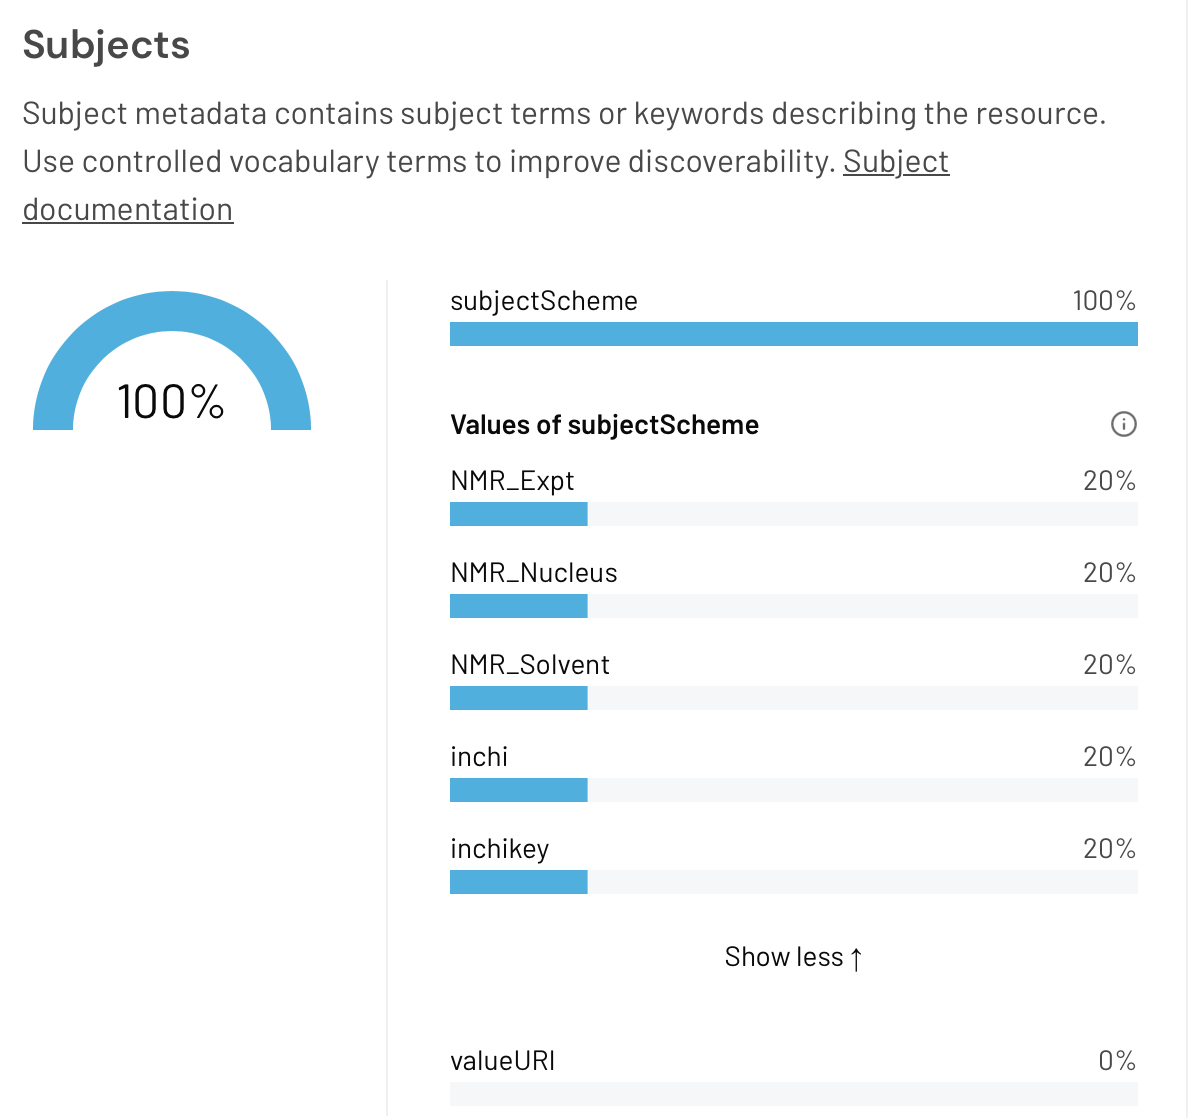
شکل 11. پنل موضوعات داشبورد ابرداده DataCite برای پرس و جو 10.
نتیجه گیری
می توان امیدوار بود که تجزیه و تحلیل سوابق فراداده داده های تحقیق با استفاده از ابزار DataCite به سرعت منجر به جمعیت بیشتر و غنی تری از این رکوردها شود. در صورت امکان، این سوابق باید با روشهای خودکار تکمیل شوند که متکی به صبر انسان نیستند. کاندیدای شخصی من برای افزایش جمعیت، فیلد Subjects است که می تواند به راحتی خودکار شود و وجود آن امکان جستجوی دقیق در مخزن ابرداده DataCite را فراهم می کند.
DOI: 10.59350/ams3m-m3t92
مراجع
- گروه کاری فراداده DataCite.، “مستندات طرحواره فراداده DataCite برای انتشار و استناد به داده های تحقیقاتی و سایر خروجی های تحقیقاتی v4.7″، DataCite2026. https://doi.org/10.14454/qdd3-ps68
- C. Cave-Ayland، M. Bearpark، C. Romain، و H. Rzepa، “CHAMP دروازه ای برای دسترسی به HPC و ابرداده است.” مجله نرم افزار منبع بازکتاب 7، ص 3824، 2022. https://doi.org/10.21105/joss.03824
این مطلب در تاریخ چهارشنبه 17 ژوئن 2026 ساعت 11:45 ارسال شده است و تحت عنوان Chemical IT ثبت شده است. میتوانید تمام پاسخهای این ورودی را از طریق فید RSS 2.0 دنبال کنید. می توانید از سایت خود پاسخ دهید یا پیگیری کنید.